Gue kira bagian tersulit dari bikin model itu ngoding. Ternyata yang bikin pusing justru milih metrik yang nggak bisa dibohongin orang bisnis.
Layar proyektor di meeting room lantai 28 masih nampilin slide nomor 14 pas kepala gue mendadak berdenyut kencang. Di slide itu, terpampang diagram lingkaran warna neon dengan tulisan mentereng: “Next-Gen AI Predictive Valuation Engine: Real-Time Commercial Forecasting”.
Klien kami, salah satu grup konglomerat pengembang terbesar di Jakarta, langsung pasang tampang antusias. Salah satu direktur mereka condongin badan ke depan, natap tim commercial leasing kantor gue, lalu nanya hal paling fatal yang bikin lidah gue kelu: “Menarik banget ini. Jadi algoritma prediksinya udah ditraining pakai data transaksi sewa riil kuartal lalu, ya? Bisa demo dashboard-nya minggu depan?”
Gue ngelirik ke arah Vina, head of sales yang dari tadi presentasi dengan gaya menggebu-gebu khas anak business development SCBD. Vina cuma senyum tenang, ngangguk mantap, dan ngejawab dengan santainya, “Tentu, Pak. Engine machine learning kami sudah fully automated dan tinggal integrasi API saja ke data internal Bapak.”
Dada gue rasanya mau rontok, Sar. Di balik meja, tangan gue langsung buka Slack dan ngetik panik ke kanal internal anak tim data. Respons lead data engineer kami cuma satu: emoji tengkorak, disusul kalimat singkat berhuruf kapital: “ENGINE APAAN ANJIR? KITA BARU BIKIN REKAP CSV MANUAL MINGGU LALU.”
Drama klasik D2 akhirnya meledak di depan muka gue: tim sales ngejual fitur futuristik yang bahkan satu baris kodenya pun belum pernah ditulis. Mereka pikir machine learning itu semacam fitur magic button di Canva atau saklar lampu yang tinggal lo cetek langsung nyala. Padahal, materi modul Introduction to AI pertemuan ketiga kampus gue minggu ini ngebahas tuntas realitas di balik dongeng AI: komputer itu nggak punya kesaktian magis. Komputer cuma belajar dari data, dan proses bikin dia bisa belajar itu jalannya panjang, berdarah-darah, dan butuh fondasi ilmiah yang solid.
Arthur Samuel, Dongeng Komputer Pintar, dan Realitas “Data is the New Oil”
Sebelum sales kantor gue jualan mimpi lebih jauh, mari kita tarik rem darurat dan bedah konsep dasarnya dulu. Modul kita buka sesi ini dengan mengutip Arthur Samuel dari era 1959. Beliau mendefinisikan machine learning sebagai bidang studi yang ngasih komputer kemampuan buat belajar tanpa harus diprogram secara eksplisit (explicitly programmed).
Bedanya apa sama pemrograman tradisional, Sar? Lo pasti udah hafal luar kepala, tapi anak sales kantor gue jelas nggak paham.
Di traditional programming, manusia ngasih dua hal ke komputer: data dan aturan (rules atau logika if-else). Komputer cuma mesin hitung patuh yang ngejalanin aturan itu buat ngeluarin output. Misalnya: IF luas bangunan > 500m² AND lokasi == SCBD THEN harga_sewa = tinggi. Kaku banget, kan? Begitu dinamika pasar berubah, aturan lo langsung basi.
Nah, machine learning ngebalik paradigma itu 180 derajat. Kita nggak ngasih aturan ke mesin. Kita ngasih komputer data mentah dan jawaban (hasil transaksi historis masa lalu), lalu ngebiarin si algoritma nyari sendiri pola, korelasi, dan rumusan matematisnya. Hasil dari proses belajar itu disebut model. Model inilah yang nantinya dikasih data baru buat ngelakuin prediksi.
Makanya sering muncul adagium populer: “Data is the new oil, AI is the new electricity”.
Data itu minyak mentah. Kalau cuma lo simpen di tangki atau lo timbun di folder Google Drive tanpa diolah, dia nggak ada gunanya sama sekali, bahkan bisa bikin polusi dan menuh-menuhin storage. Supaya minyak mentah itu bisa jadi bensin beroktan tinggi yang ngegerakkin mesin AI, lo butuh proses yang namanya Data Mining. Lo harus ngegali, ngebersihin, ngekstraksi pola-pola tersembunyi (hidden patterns), dan memvalidasi informasi berharga dari tumpukan data raksasa itu.
Masalahnya, minyak mentah di kantor konsultan properti kayak tempat gue kerja bentuknya bukan sumur minyak yang rapi, melainkan tumpukan lumpur hisap bernama Big Data.
Jeratan 5V: Kenapa Bikin Model Prediksi Properti Nggak Segampang Mulut Sales
Tim sales kantor gue mikir, modal arsip transaksi properti kantor sejak era Bram masih mimpin divisi valuasi dulu udah cukup buat langsung disulap jadi AI. Mereka nggak paham kalau tumpukan data transaksi puluhan tahun itu kena hantaman badai 5V yang jadi karakteristik utama Big Data:
Volume (Ukuran Data)
Data transaksi gedung, catatan sewa, biaya maintenance, sampai lalu lintas logistik penyewa selama bertahun-tahun itu ukurannya masif. Buat melatih model prediktif yang handal, lo butuh ribuan hingga jutaan baris data representatif, bukan cuma 50 lembar laporan tahunan yang dirangkum rapi.Velocity (Kecepatan Perubahan Data)
Harga properti di Jakarta itu dinamis banget. Perubahan suku bunga BI, regulasi tata ruang baru, atau pembukaan stasiun LRT baru langsung ngubah nilai kapitalisasi suatu kawasan dalam hitungan minggu. Kalau data lo statis, model lo bakal memprediksi masa depan pakai kacamata masa lalu yang udah usang.Variety (Keragaman Format Data)
Ini mimpi buruk anak data di kantor gue. Datanya nggak cuma angka di tabel SQL. Ada denah arsitektur dalam format CAD, scan sertifikat tanah berformat PDF buram, catatan notulen meeting negosiasi dalam format Word, sampai chat WhatsApp antara broker dan pemilik gedung. Gimana caranya algoritma matematika mencerna data yang variasinya seberantakan itu tanpa tahap ekstraksi yang matang?Veracity (Tingkat Kepercayaan & Kebersihan Data)
Data properti lokal itu rawan noise dan inkonsistensi. Ada nilai transaksi yang sengaja dikecilin di atas kertas demi urusan pajak, ada kolom luas tanah yang satuannya campur aduk antara meter persegi dan hektar, bahkan ada human error salah ketik nol. Kalau data kotor ini lo lolosin, model ML lo bakal menganut prinsip abadi komputer: Garbage In, Garbage Out.Value (Nilai Bisnis Riil)
Ini yang paling sering dilupakan orang bisnis. Buat apa lo keluar biaya ratusan juta buat sewa server GPU dan nyewa data scientist kalau hasil prediksinya cuma ngasih tahu hal yang udah jelas diketahui manusia biasa, kayak: “Gedung di Sudirman lebih mahal dibanding gedung di pinggiran luar tol”. Nilai bisnis baru muncul kalau model itu bisa nemuin anomali pasar atau peluang arbitrase sewa yang luput dari mata manusia.
Tanpa strategi data mining yang jelas buat ngejinakin 5V ini, janji Vina ke klien soal engine prediksi otomatis tadi bener-bener cuma omong kosong marketing.
Tiga Mazhab Belajar Mesin: Lo Mau Mesin Lo Didikte, Dilepas, atau Dilatih Mandiri?
Biar Sari makin gampang ngebayangin fondasi teori modul 3 ini buat kerangka GPBSales lo, gue bedah tiga tipe utama machine learning yang kita pelajari di kampus:
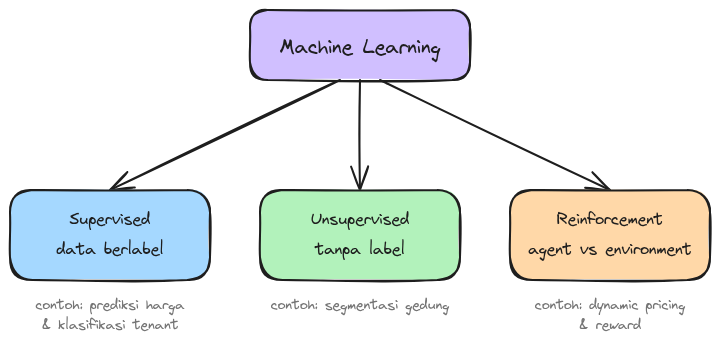
Tiga mazhab belajar mesin, versi gambar.
1. Supervised Learning (Belajar Terbimbing)
Ini tipe yang paling banyak dipakai di dunia korporat dan paling relevan buat kasus prediksi valuasi kantor gue (serta tesis lo). Di sini, mesin dikasih data latih yang udah punya label (ground truth). Komputer dikasih soal ujian sekaligus kunci jawabannya, biar dia belajar ngenalin polanya.
Supervised learning kebagi jadi dua cabang besar:
- Regresi (Regression): Kalau output yang mau ditebak berupa angka kontinu. Contohnya: memprediksi harga sewa per meter persegi di kawasan Mega Kuningan berdasarkan luas lantai, umur gedung, jarak ke stasiun MRT, dan rasio parkir.
- Klasifikasi (Classification): Kalau output yang mau ditebak berupa kategori atau kelas diskrit. Contohnya: memprediksi apakah calon tenant bakal default (gagal bayar) atau lancar, atau memprediksi apakah klien bakal memperpanjang kontrak sewa (renew vs churn).
2. Unsupervised Learning (Belajar Mandiri Tanpa Label)
Di sini, kita ngasih tumpukan data mentah ke komputer tanpa ngasih label atau kunci jawaban. Mesin dibiarin nyari sendiri struktur, pola kesamaan, atau anomali yang ada di dalam data.
Teknik paling populernya adalah Clustering. Misalnya, tim riset kantor gue mau ngelompokkin 500 gedung perkantoran di Jabodetabek ke dalam beberapa klaster profil penyewa tanpa mendikte kriterianya. Algoritma bakal nemuin sendiri bahwa ada klaster gedung yang karakternya disukai oleh startup teknologi, ada klaster yang cuma diisi firma hukum dan perbankan, dan ada klaster gedung tua yang penyewanya sensitif banget sama harga service charge.
3. Reinforcement Learning (Belajar Lewat Interaksi & Konsekuensi)
Ini mazhab yang paling canggih sekaligus paling kompleks. Nggak ada data historis statis kayak dua tipe di atas. Di sini ada konsep Agent yang beroperasi di dalam suatu Environment. Si agent bakal ngambil tindakan (action), lalu environment bakal ngasih respon berupa Reward (kalau tindakannya bener/menguntungkan) atau Penalty (kalau tindakannya salah/merugikan). Tujuannya: si agent harus belajar memaksimalkan total reward dalam jangka panjang lewat trial and error.
Penerapannya di dunia nyata sering dipakai buat navigasi robot, mobil otonom, atau main catur/Go. Di dunia bisnis properti, ini bisa dipakai buat dynamic pricing algorithm kamar hotel atau serviced apartment, di mana sistem otomatis naikin atau turunin tarif tiap jam berdasarkan fluktuasi demand, cuaca, dan tingkat pembatalan demi dapet pendapatan maksimal.
Anatomi ML Pipeline: Kenapa Model Bukan Tongkat Sihir
Pas Vina dengan entengnya bilang “tinggal integrasi API”, gue pengen banget nge-print satu kalimat besar dan tempel di jidatnya: model itu bagian yang paling gampang.
Di kelas, dosen gue ngebedah alur kerja machine learning dari data mentah sampai dipakai di kantor. Waktu dia selesai, gue sadar kenapa Vina dan gue sama-sama salah. Vina mikir prosesnya cuma beli model lalu sambung API. Gue mikir prosesnya soal ngoding. Padahal dua-duanya cuma ujung yang kelihatan.
Versi manusianya begini:
Satu, bersihin datanya. Data dari divisi properti itu nggak rapi. Ada baris dobel, ada harga kosong, ada luas gedung yang angkanya nggak masuk akal, ada satu gedung yang ditulis dengan tiga nama berbeda. Sebelum mesin bisa belajar apa pun, semua itu harus dibereskan. Ini bagian yang paling lama, biasanya 70 sampai 80 persen waktu proyek. Bukan karena orangnya lambat, tapi karena data kantor memang begitu adanya.
Contohnya sederhana. Waktu Adit ngumpulin data sewa kantor dari tiga sistem, dia nemu satu gedung yang di CRM tercatat occupied, di file Excel available, dan di email tim office masih nego. Buat manusia, itu jelas satu gedung dengan tiga status. Buat mesin, itu tiga gedung berbeda. Sebelum kita ngomongin model, kita harus memutuskan mana yang benar dulu.
Dua, belah datanya jadi dua. Satu bagian buat latihan, satu bagian buat ujian. Model cuma boleh belajar dari bagian latihan. Bagian ujian disembunyikan sampai akhir. Kalau model sudah lihat soal ujian selama latihan, dia kelihatan pintar padahal cuma hafal jawabannya. Ini kesalahan yang paling sering nggak kelihatan di demo.
Tiga, latih mesinnya. Di sini mesin nyari pola: gedung dengan ciri apa yang harganya cenderung naik, tenant dengan tanda apa yang cenderung telat bayar. Bagian ini yang paling keren kalau dilihat di layar, dan bagian ini juga yang paling cepat selesai. Yang bikin lama justru dua langkah sebelumnya.
Empat, uji dan pantau setelah dipakai. Model yang lulus ujian belum tentu aman di lapangan. Data berubah, pasar berubah, kebiasaan klien berubah. Kalau nggak ada orang yang memantau, model bisa melenceng berbulan-bulan tanpa ada yang sadar sampai klien komplain.
Nggak ada satu pun dari empat langkah itu yang selesai dengan “tinggal integrasi API”. Dan nggak ada satu pun yang bisa dikerjakan tanpa orang yang tahu arti data kantor ini. Di sinilah Vina dan gue akhirnya sepakat soal satu hal: yang mahal bukan modelnya, tapi kerjaan di sekitarnya.
Metrik Evaluasi: Ilusi Angka Akurasi yang Menipu Orang Bisnis
Ini bagian paling krusial yang wajib lo kuasai luar kepala buat tesis dan GPBSales, Sar. Orang non-teknis kayak sales atau bos-bos manajemen kantor gue cuma tahu satu kata: Akurasi. Mereka bakal nanya, “Model lo akurasinya berapa persen? 95 persen? Keren, langsung jual ke klien!”
Padahal di dunia machine learning, bersandar cuma ke angka akurasi itu jebakan betmen nomor satu yang namanya Accuracy Paradox.
Coba bayangin kasus klasifikasi tenant berisiko tinggi (high-risk tenant) di kantor gue. Dari 1.000 tenant yang nyewa gedung, realitasnya cuma ada 10 tenant yang bener-bener nakal dan kabur nggak bayar sewa. Artinya, 990 tenant adalah tenant aman.
Kalau gue bikin model bodoh yang nggak mikir sama sekali, dan model itu gue suruh nebak secara hardcode: “Semua tenant pasti aman”, tebak berapa akurasi model bodoh gue?
Akurasi = (Tebakan Benar) / (Total Data) = (990) / (1000) = 99%
Secara angka statistik, model gue kelihatan jenius dengan akurasi 99 persen! Tapi di mata bisnis, model itu sampah total. Kenapa? Karena dia gagal mendeteksi 10 tenant bermasalah yang bikin kantor boncos miliaran rupiah.
Makanya kita butuh cara mengukur yang lebih jujur. Bukan satu angka akurasi, tapi tiga pertanyaan berbeda:
- Presisi: dari semua yang dituduh bermasalah oleh model, berapa yang benar-benar bermasalah? Ini penting kalau salah tuduh itu mahal. Klien korporat bonafit dituduh calon penipu, reputasi kantor ancur, deal sewa melayang.
- Recall: dari semua yang benar-benar bermasalah, berapa yang berhasil ditangkap model? Ini penting kalau kecolongan itu mahal. Tenant nakal lolos, kantor rugi miliaran.
- F1: kompromi antara dua-duanya. Dipakai kalau jumlah kasus bermasalah jauh lebih sedikit daripada yang aman, seperti data tenant atau transaksi properti.
Contohnya di kantor gue. Kalau model bilang semua tenant aman, presisinya kelihatan bagus karena hampir semua tenant memang aman. Tapi recall-nya nol, karena sepuluh tenant nakal nggak ketangkep satu pun. Angka yang kelihatan bagus bisa menyembunyikan model yang nggak berguna.
Selain metrik, ada satu penyakit lain yang harus dicek: model yang terlalu hafal data latihan. Dia kelihatan sempurna di data lama, tapi jeblok begitu ketemu data baru. Namanya overfitting. Sebaliknya, model yang terlalu sederhana juga nggak nangkep pola, namanya underfitting. Obatnya bukan menambah kecanggihan, tapi menahan diri: jangan bikin model terlalu rumit, dan uji di data yang belum pernah dia lihat.
Ruang Diskusi: Menyelamatkan Wajah Kantor dari Janji Palsu
Sari, drama sales overpromise ini sekarang resmi jadi beban moral gue dan tim analis. Besok pagi tim gue diminta manajemen buat bikin draf proposal klarifikasi ke klien, biar ekspektasi mereka bisa ditarik balik ke bumi tanpa bikin kantor kehilangan muka atau batal kontrak.
Mumpung lo lagi mendalami pipeline data penjualan di GPBSales dan ngerancang metodologi tesis lo, gue mau nodong perspektif analitis lo soal beberapa hal ini:
Data historis yang campur aduk: Klien minta model estimasi sewa yang presisi, tapi data kantor penuh format campur aduk: PDF, Excel versi lama, dan catatan negosiasi. Mana yang layak dipakai, mana yang harus dibuang, dan bagaimana lo memutuskan?
Memilih ukuran yang bisa dijelaskan ke direktur: Kalau lo harus presentasi ke direktur klien, lo pilih ukuran yang mana: yang paling jarang salah tuduh, yang paling jarang kecolongan, atau yang seimbang? Jelaskan pilihan itu pakai bahasa mereka, bukan bahasa teknis.
Pagar untuk tim bisnis: Aturan apa yang harus dibuat supaya tim bisnis nggak bisa menjanjikan kemampuan AI yang belum terbukti?
Tumpukan mug kopi di samping laptop gue udah dingin semua, dan grup Slack tim data kantor masih berisik debat kusir soal revisi dokumen scope of work buat klien besok pagi. Tolong kasih pencerahan lo sebelum gue bener-bener khilaf ngelempar slide presentasinya Vina ke tempat sampah daur ulang.
Sampai ketemu di sesi belajar akhir pekan ini, Sar. Tetap waras di tengah gempuran deadline tesis dan selamat ngulik data!
Nik
💬 Diskusi
Mau ikut nimbrung atau menjawab pertanyaan di atas? Login pakai akun GitHub untuk meninggalkan komentar.