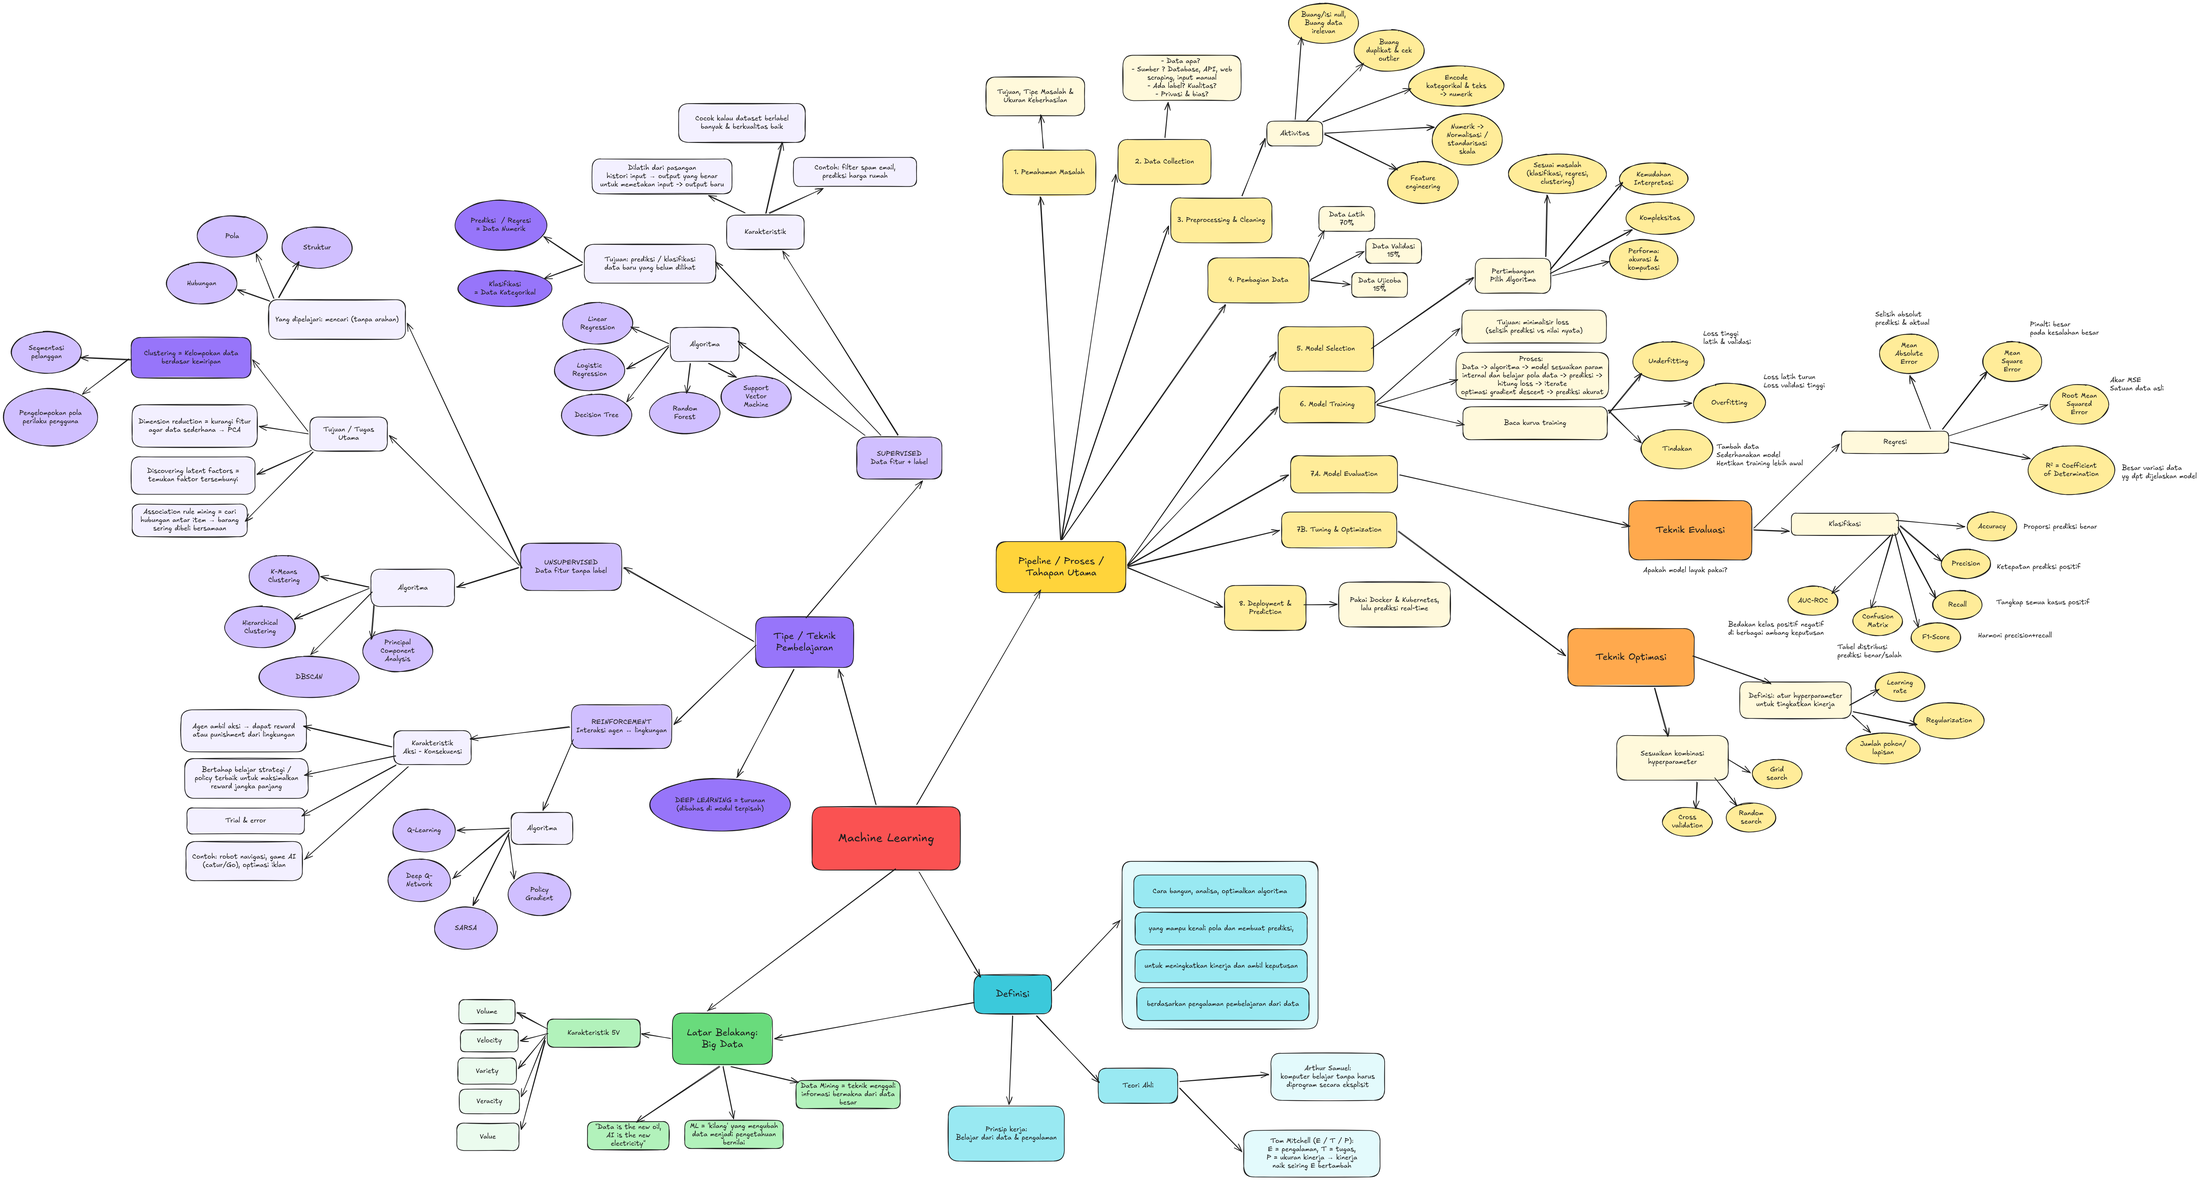
Sesi 3 matkul Implementasi Artificial Intelligence masuk ke topik yang paling aku tunggu sejak awal: machine learning. Seperti biasa, modul yang cuma dibaca doang nggak akan nempel di kepalaku, jadi aku gambar ulang isinya jadi mindmap. Yang ini aku kerjakan dua putaran, versi awal dulu buat ngobrol sama materinya, lalu aku lengkapi sampai semua cabangnya nyambung.
Di peta ini cabang utamanya begini:
- Definisi dan latar belakang: Arthur Samuel mendefinisikan machine learning sebagai komputer yang belajar tanpa harus diprogram eksplisit, sementara Tom Mitchell merumuskannya lewat E/T/P: pengalaman, tugas, dan ukuran kinerja. Latar belakangnya adalah Big Data dengan karakteristik 5V, dan ML ibarat kilang yang mengubah data jadi pengetahuan bernilai.
- Tiga tipe pembelajaran: supervised belajar dari data berlabel untuk prediksi dan klasifikasi, contohnya filter spam dan prediksi harga rumah; unsupervised mencari pola tanpa label lewat clustering, reduksi dimensi, dan asosiasi antar item; reinforcement belajar dari interaksi agen dengan lingkungan lewat reward dan punishment. Deep learning disebut sebagai turunannya yang dibahas di modul terpisah.
- Pipeline delapan tahap: dari pemahaman masalah, pengumpulan data, preprocessing dan cleaning, pembagian data (70% latih, 15% validasi, 15% uji), pemilihan algoritma, training, evaluasi, tuning, sampai deployment. Di preprocessing aku catat juga hal praktis seperti membuang duplikat, menangani outlier, encoding data kategorikal, dan normalisasi.
- Teknik evaluasi: regresi diukur dengan MAE, MSE, RMSE, dan R squared, sementara klasifikasi pakai accuracy, precision, recall, F1-score, confusion matrix, dan AUC-ROC. Pertanyaan besarnya cuma satu: apakah model ini layak dipakai?
- Teknik optimasi: hyperparameter seperti learning rate, regularization, dan jumlah pohon atau lapisan disetel lewat grid search, random search, dan cross validation. Kurva training dipakai untuk membaca apakah model underfitting atau overfitting.
Yang bikin peta ini terasa lengkap adalah bagian capaian belajarnya: definisi, pipeline, evaluasi, dan optimasi disusun jadi satu alur, jadi aku tahu posisi tiap materi. Peta ini aku unggah sebagai bukti belajar sekaligus bahan refleksi. Kalau ada cabang yang kurang tepat atau bisa ditambahkan, aku terbuka untuk masukan.
💬 Diskusi
Mau ikut nimbrung atau menjawab pertanyaan di atas? Login pakai akun GitHub untuk meninggalkan komentar.