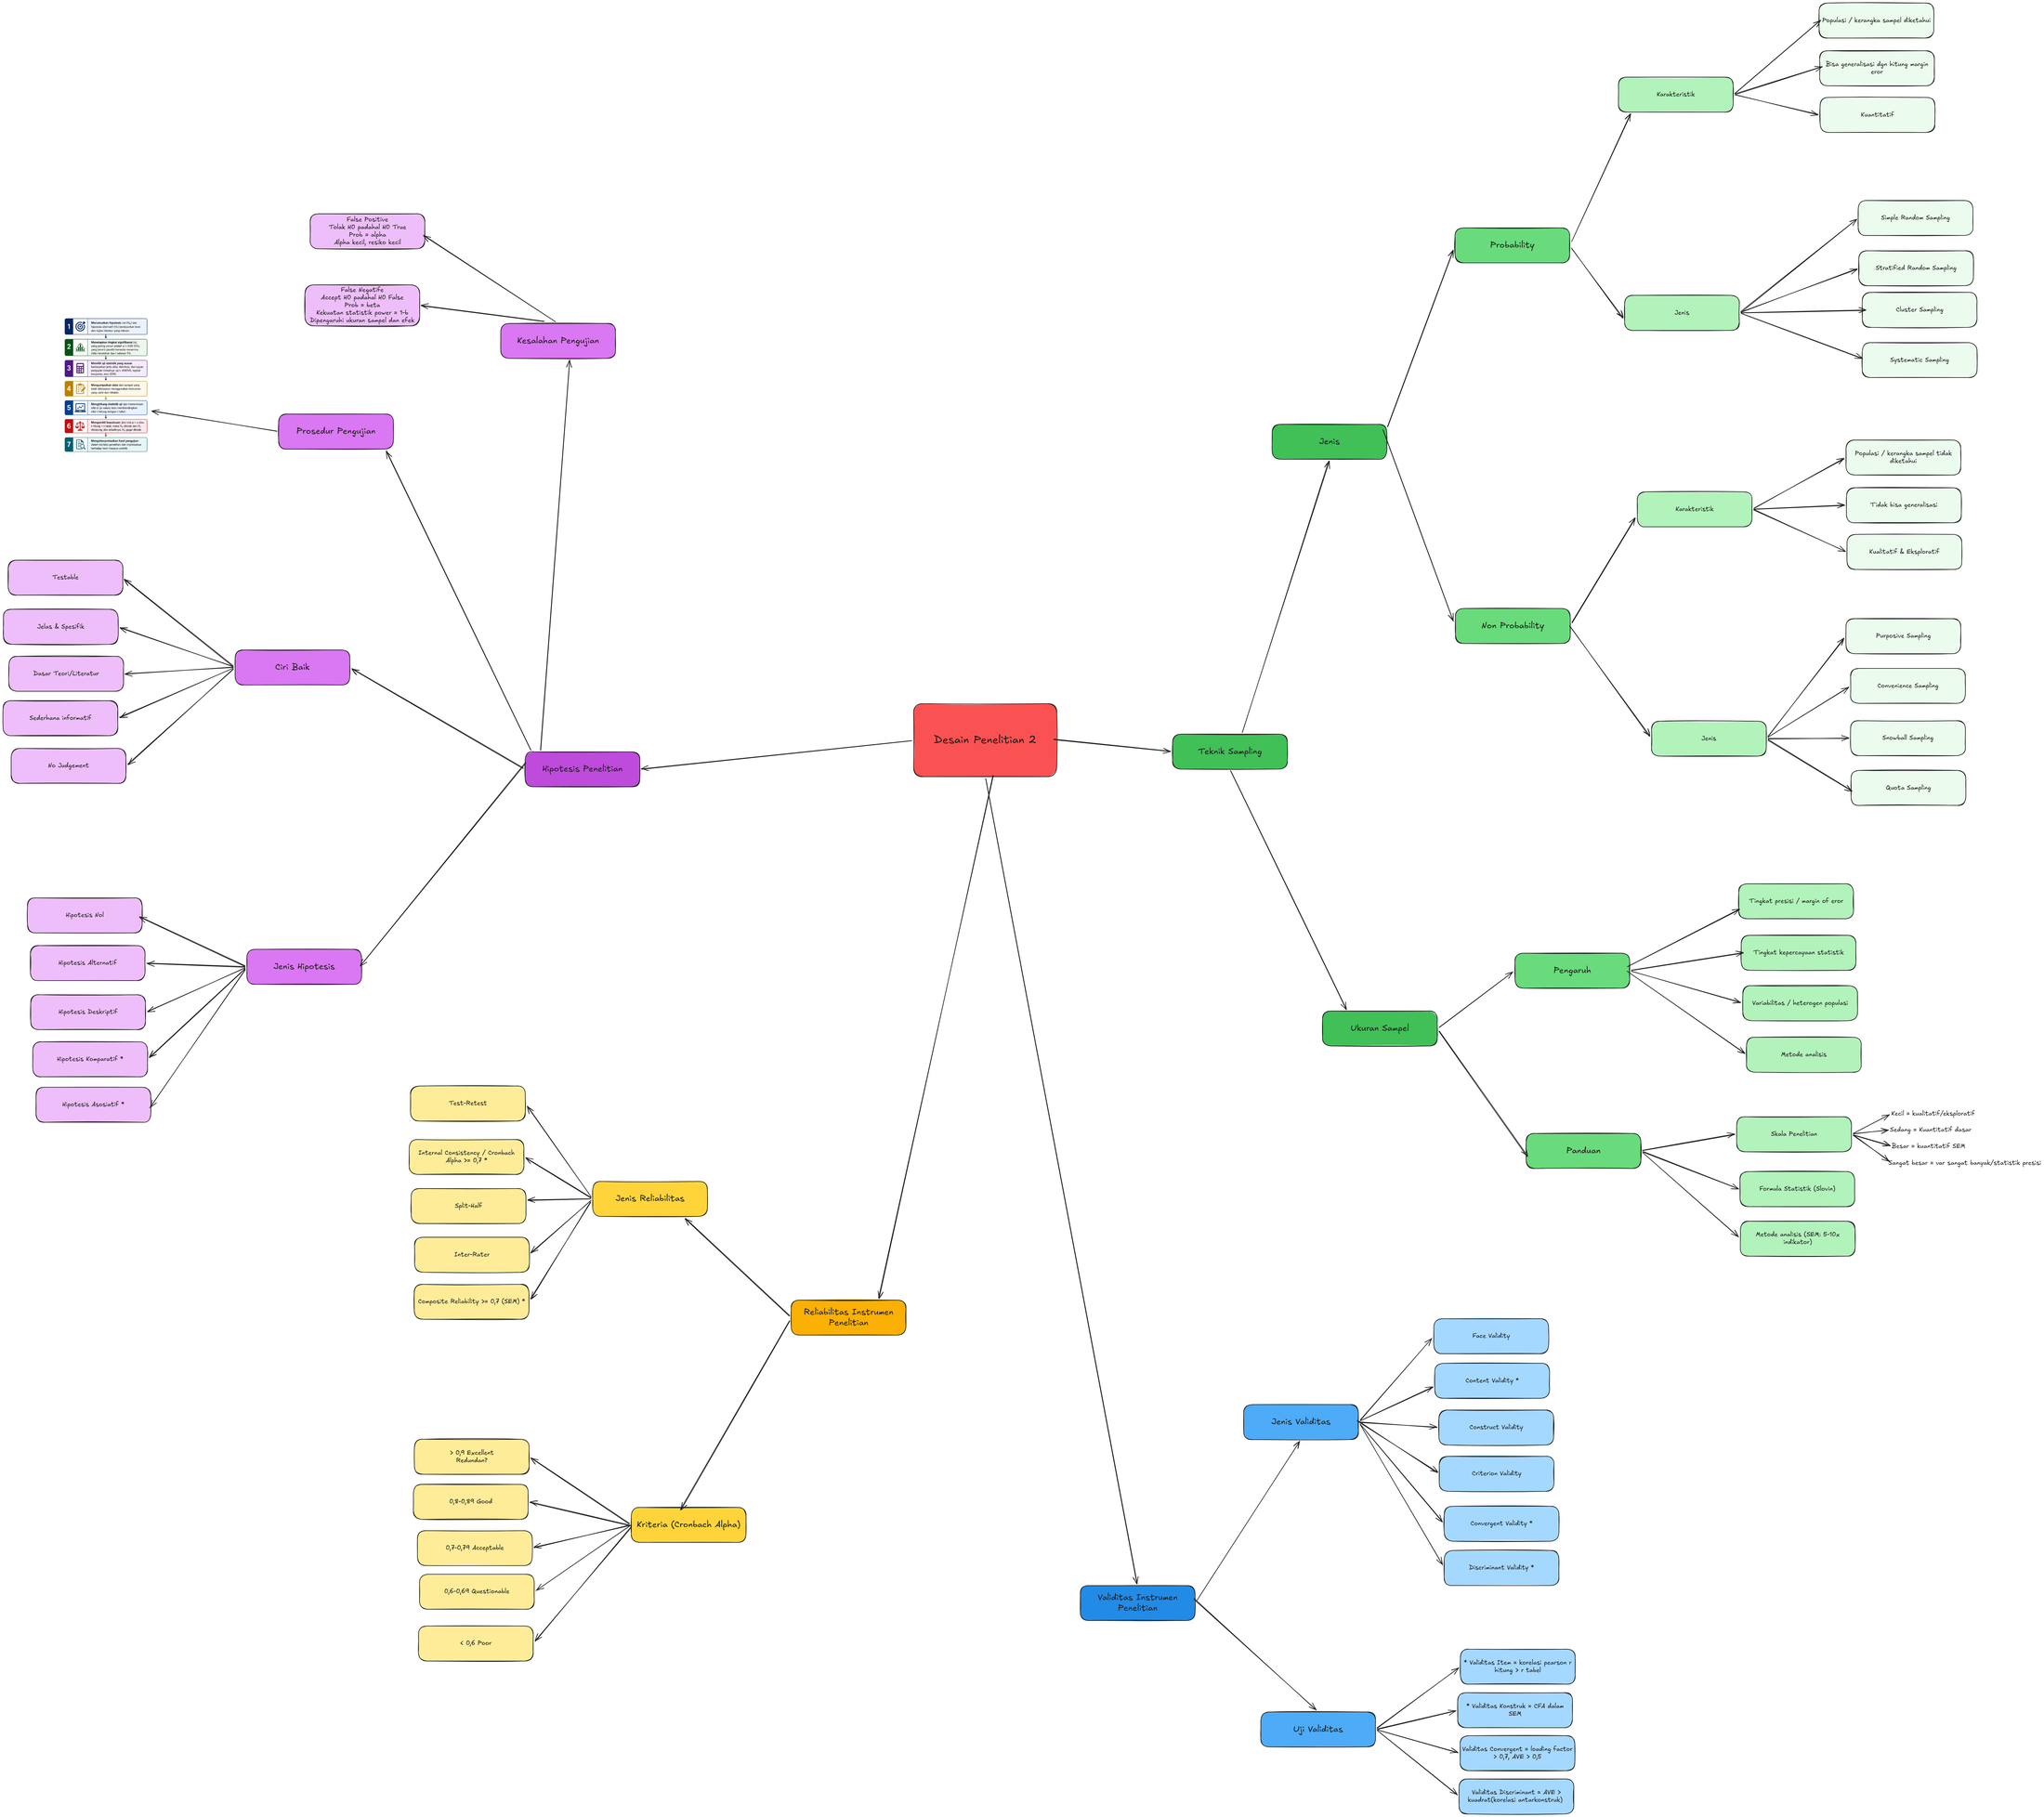
Sesi ini yang paling bikin aku berhenti berkali-kali. Bukan karena materinya tidak jelas, tapi karena istilah hitungannya datang beruntun: alpha, beta, nilai-p, loading, AVE, Cronbach. Waktu dibaca berurutan dari modul, semuanya terasa seperti satu dinding angka.
Setelah aku gambar, kelihatan bahwa sebenarnya ada empat pertanyaan berbeda di balik angka-angka itu. Seberapa kuat hubungannya, boleh dipercaya atau tidak, cocok atau tidak alat ukurnya, dan berapa orang yang perlu ditanya. Semuanya aku tuangkan ke satu peta.
Isi singkatnya:
- Hipotesis penelitian: H0 adalah pernyataan netral yang diuji, H1 adalah dugaan peneliti. Jenisnya deskriptif, komparatif, dan asosiatif. Ciri hipotesis yang baik itu bisa diuji, jelas dan spesifik, berlandas teori dan literatur, sederhana, dan tidak mengandung penilaian pribadi.
- Kesalahan pengujian: false positive terjadi saat H0 ditolak padahal H0 benar, peluangnya adalah alpha. False negative terjadi saat H0 diterima padahal H0 salah, peluangnya beta, dan kekuatan statistik adalah 1 dikurangi beta.
- Teknik sampling: probability sampling terdiri dari simple random, systematic, stratified, dan cluster. Non-probability terdiri dari purposive, convenience, snowball, dan quota. Pembedanya ada di kerangka sampel dan kemampuan generalisasi.
- Ukuran sampel: ada panduan berdasarkan skala penelitian dari kecil sampai sangat besar, ada formula Slovin, dan ada empat faktor yang mempengaruhinya yaitu tingkat presisi, tingkat kepercayaan, variabilitas populasi, dan metode analisis termasuk aturan SEM lima sampai sepuluh kali jumlah indikator.
- Reliabilitas instrumen: jenisnya test-retest, split-half, inter-rater, internal consistency, dan composite reliability. Ada juga tangga penilaian Cronbach Alpha dari di bawah 0,6 yang poor sampai di atas 0,9 yang excellent tapi justru patut dicurigai redundan.
- Validitas instrumen: jenisnya face, content, construct, dan criterion. Uji validitas item memakai korelasi Pearson, uji validitas konstruk memakai CFA di dalam SEM, dengan convergent validity loading di atas 0,7 dan AVE di atas 0,5, lalu discriminant validity dengan AVE yang lebih besar dari kuadrat korelasi antarkonstruk.
Peta ini yang bikin aku akhirnya bisa membedakan dua hal yang sebelumnya sering aku tertukar: pengaruh yang kuat belum tentu bisa dipercaya, dan alat ukur yang konsisten belum tentu mengukur hal yang benar.
Aku unggah mindmap ini sebagai bukti bahwa aku benar-benar sudah belajar, bukan sekadar membaca. Kalau ada cabang yang bisa ditambahkan atau ada yang salah tempat, aku terbuka untuk masukan.
💬 Diskusi
Mau ikut nimbrung atau menjawab pertanyaan di atas? Login pakai akun GitHub untuk meninggalkan komentar.